Reconocimiento de voz en español: guía práctica por variante
Descubre cómo transcribir llamadas con precisión: compara variantes del español, configura el reconocimiento de voz y pruébalo con tu propio audio.
 Matías CasasolaFundador y CEO de Anunzi
· 13 min de lectura
En este artículo
- ¿Cómo funciona el reconocimiento de voz en español?
- ¿Cuándo usar el modo síncrono, asíncrono o streaming?
- Cómo configurar el micrófono y los permisos
- Cómo mejorar la precisión con adaptación y puntuación
- Cómo transcribir llamadas con varios interlocutores
- Checklist para evaluar soluciones de reconocimiento de voz
- Qué dice la evidencia sobre agentes de voz en atención telefónica
- Proveedores y tecnologías de reconocimiento de voz en español
- Modelos de n-gramas frente a modelos neuronales
- Procesamiento y normalización del texto transcrito
- Acentos, dialectos y jerga en español
- Integración con CRM y plataformas de atención al cliente
- Privacidad y seguridad en el procesamiento de voz
- Por qué conviene un enfoque local en español
- Agentes de voz en español para tu proyecto con Anunzi
- Preguntas frecuentes
- Fuentes
- Recomendaciones
El reconocimiento de voz en español (ASR) convierte audio hablado en texto y sirve para dictar, transcribir llamadas, buscar por voz y alimentar agentes de voz. Su precisión depende de la variante regional que elijas (es-ES, es-419, es-MX o es-US) y de cómo lo configures. A continuación vemos cómo funciona, qué modo usar, cómo prepararlo y cómo probarlo con tu propio audio.
En resumen:
- El modo síncrono sirve para dictados breves, el asíncrono para grabaciones largas y el streaming para agentes de voz y llamadas en vivo.
- Compara cada variante regional con el mismo archivo y vocabulario; si tus hablantes abarcan varios países, prueba una muestra por región y valídala con hablantes nativos.
- Añade nombres, direcciones y siglas a la lista de adaptación, pero prueba cada cambio con el mismo audio: un impulso excesivo genera falsos positivos.
- Ajusta el mínimo y el máximo de hablantes a cada llamada: un límite alto inventa voces, uno bajo las mezcla, y los solapamientos y el eco reducen la exactitud.
- Trata la puntuación automática como un borrador y revisa especialmente nombres, cifras, direcciones y negaciones, porque una palabra omitida puede cambiar el sentido.
¿Cómo funciona el reconocimiento de voz en español?
Un sistema de reconocimiento de voz toma una señal de audio, la divide en fragmentos y predice qué palabras se pronunciaron. No confundas esta tecnología con el TTS (síntesis de voz), que hace el camino inverso: convierte texto en voz. Si quieres ver ese otro lado, tenemos una guía sobre voces en español con IA para agentes conversacionales.
Los modelos se entrenan con datos de un idioma y de una región, y por eso no todos rinden igual. La documentación de Cloud Speech-to-Text lista compatibilidad por idioma, región, modelo y función, así que no conviene asumir que todas las variantes ofrecen lo mismo. Estas son las razones para probar la variante regional que de verdad usan tus hablantes:
- Puntuación automática, adaptación de vocabulario y diarización pueden estar disponibles en una variante y no en otra.
- Los códigos regionales cambian el modelo que se aplica, y con él los resultados con acentos y léxico local.
- Un mismo audio puede dar textos distintos según el modelo elegido, así que compara siempre con el mismo archivo.
¿Cuándo usar el modo síncrono, asíncrono o streaming?
Google Cloud describe tres métodos de reconocimiento: síncrono, asíncrono y streaming. Elegir bien evita esperas innecesarias y costes de integración.
- Síncrono: pensado para audio corto cuando necesitas la respuesta enseguida, por ejemplo una orden de voz o un dictado breve en un formulario.
- Asíncrono: procesa grabaciones largas y lotes, como el archivo de llamadas de un mes. Envías el audio y recoges el texto después.
- Streaming: devuelve resultados en tiempo real mientras la persona habla. Es el modo de los agentes de voz y del monitoreo de llamadas en vivo.
Si tu objetivo es atender llamadas con un agente, el streaming es casi siempre el punto de partida. Para auditar conversaciones ya grabadas, el modo asíncrono suele bastar.
Cómo configurar el micrófono y los permisos
Antes de culpar al modelo, revisa la captura de audio. Muchos fallos vienen de un permiso revocado o de un dispositivo mal elegido.
- En Windows, la aplicación debe declarar la capacidad de micrófono y comprobar que el usuario no la haya revocado, tal como explica Microsoft Learn. Si no hay permiso, el reconocimiento no arranca.
- Selecciona el dispositivo de entrada correcto en el sistema y en la app, sobre todo si usas auriculares o un micrófono USB.
- Ajusta la ganancia para que la voz no sature ni quede baja, y activa la reducción de ruido si el entorno es ruidoso.
- El reconocimiento continuo suele necesitar conexión de red, y sin ella la sesión debe finalizar. El soporte de Microsoft detalla este requisito para el dictado en Windows.
Consejo profesional: graba una frase de prueba con tu micrófono real antes de cualquier evaluación y escúchala; si tú no la entiendes bien, el modelo tampoco.
Cómo mejorar la precisión con adaptación y puntuación
Los modelos genéricos fallan con nombres propios, marcas, calles y términos de tu sector. La solución es la adaptación: una lista de frases (PhraseSet) o de vocabulario que le dice al sistema qué esperar. La documentación de adaptación de Google indica que esta lista mejora el reconocimiento de términos del dominio.
- Incluye nombres de producto, apellidos frecuentes, calles y siglas que aparecen en tus llamadas.
- Usa el impulso (boost) con moderación: un valor excesivo puede introducir errores y provocar falsos positivos donde el sistema “oye” un término que nadie dijo.
- Prueba antes y después de cada cambio con el mismo audio para medir el efecto real.
La puntuación automática merece otra advertencia. La RAE, en su análisis sobre puntuación y prosodia, recuerda que la entonación transmite matices que la escritura no refleja por completo, y que una pausa hablada no siempre equivale a una coma escrita.
La puntuación automática no sustituye la revisión editorial: revisa nombres propios, cifras, direcciones y negaciones en cada transcripción.
Cómo transcribir llamadas con varios interlocutores
En una llamada de atención o de cobranzas pueden hablar varias personas. La diarización etiqueta cada palabra con un identificador de hablante para que sepas quién dijo qué. La documentación sobre múltiples voces explica cómo activarla y recuperar las palabras con su etiqueta de hablante (speaker_tag).
- Configura min_speaker_count y max_speaker_count según el caso: en una llamada de atención puede haber varios interlocutores; en una reunión, también.
- Si fijas un máximo demasiado alto, el sistema puede inventar hablantes; si lo fijas demasiado bajo, mezclará voces.
- Las voces que se solapan siguen siendo un punto débil y reducen la exactitud.
- La calidad del audio pesa tanto como el ajuste: una grabación con eco confunde a cualquier modelo.
Combina la diarización con marcas temporales para localizar el momento exacto de una promesa de pago o de una queja.
Checklist para evaluar soluciones de reconocimiento de voz
Compara las soluciones con tu propio audio y no con demos de catálogo. Estos criterios cuentan: variantes regionales soportadas, diarización, adaptación de vocabulario, latencia y confianza por palabra.
- Reúne muestras reales de llamadas, con sus ruidos, acentos y cortes habituales.
- Mide la exactitud en lo que más importa: nombres, direcciones, importes y fechas.
- Evalúa la diarización y las marcas temporales en llamadas con varios interlocutores.
- Repite la prueba con la lista de vocabulario activada y compara.
Consejo profesional: compara siempre la misma variante regional y el mismo vocabulario real en todas las herramientas; si cambias una de las dos, el resultado deja de ser comparable.
Qué dice la evidencia sobre agentes de voz en atención telefónica
Para la atención telefónica, la documentación técnica apunta a prácticas claras que aplicamos cuando desplegamos agentes.
- Elegir el código regional correcto y adaptar el modelo con tu vocabulario mejora los resultados en producción, según la documentación de Google.
- La RAE señala que la puntuación no refleja toda la prosodia, así que revisa nombres y negaciones.
- Haz pruebas iterativas con métricas claras antes del despliegue, no después.
Proveedores y tecnologías de reconocimiento de voz en español
El mercado ofrece varias opciones maduras, y conviene conocer qué aporta cada una sin tratarlas como equivalentes. Google Cloud Speech-to-Text documenta compatibilidad por idioma, región, modelo y función, y distingue los modos síncrono, asíncrono y streaming. Es una de las referencias técnicas más detalladas para configurar variantes de español, adaptación de vocabulario y diarización.
Microsoft ofrece reconocimiento de voz integrado en Windows y en sus APIs para aplicaciones. Según Microsoft Learn, las apps deben declarar la capacidad de micrófono y pueden usar gramáticas predefinidas para dictado y búsqueda web, o restricciones personalizadas con SRGS cuando necesitas más control. Sus interacciones de voz combinan reconocimiento y síntesis, y permiten desde dictado libre hasta comandos acotados.
Otros proveedores grandes, como IBM, completan el panorama, pero no vamos a atribuirles características que no podamos respaldar con documentación citada aquí. Lo útil es comparar con criterios fijos:
- Variantes de español soportadas y si cubren la tuya.
- Modos disponibles: tiempo real, lotes o ambos.
- Funciones como diarización, adaptación y puntuación en tu variante.
- Condiciones de conexión: continuo con red o con límites sin conexión.
Antes de contratar, repite el checklist de la sección anterior con tu audio. Una ficha técnica no sustituye la prueba.
Modelos de n-gramas frente a modelos neuronales
Los modelos basados en n-gramas calculan la probabilidad de una palabra a partir de las pocas que la preceden. Son ligeros y rápidos, y funcionan bien con vocabularios cerrados, como un menú de comandos. Su límite es el contexto: solo “ven” una ventana corta de palabras, así que se equivocan cuando una frase necesita entender un fragmento más largo.
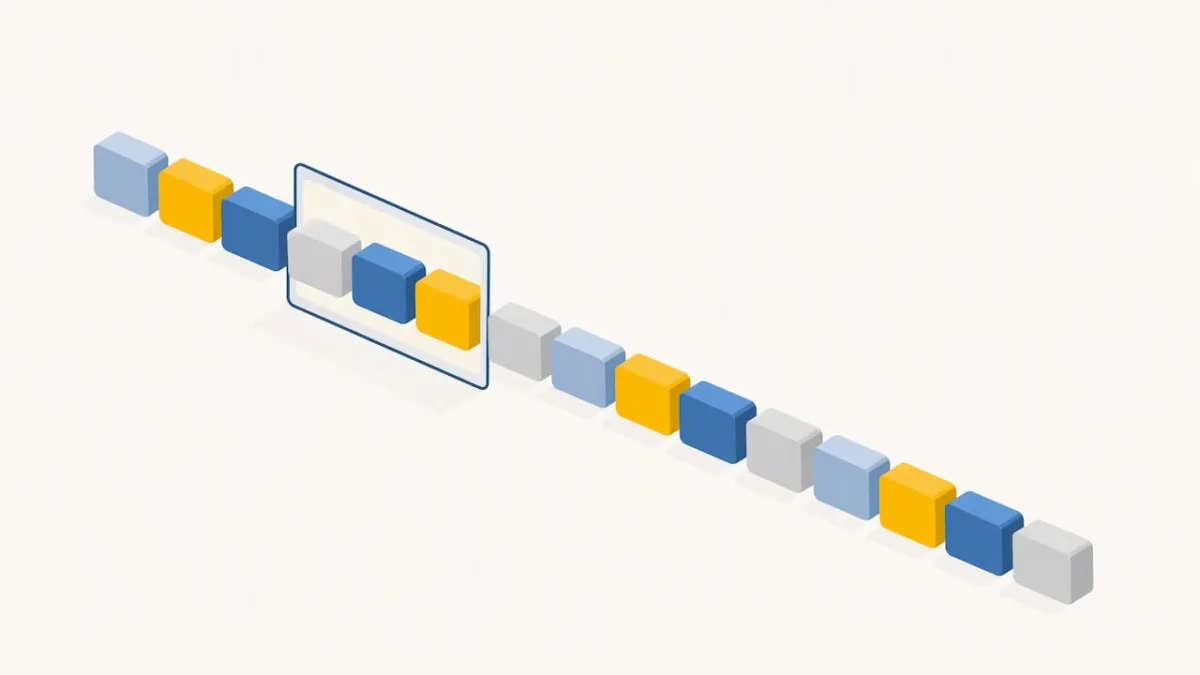
Los modelos neuronales aprenden representaciones del audio y del lenguaje a la vez. Capturan contexto más amplio y manejan mejor la variación de acentos, el ruido y el habla espontánea. A cambio, requieren más cómputo y más datos de entrenamiento, y su comportamiento es más difícil de predecir al detalle.
Para ti, la diferencia práctica es esta:
- Si tu vocabulario es limitado y estable, un enfoque acotado, como las gramáticas personalizadas de Windows, puede bastar y reducir errores.
- Si recibes habla libre, con interrupciones y léxico variado, los modelos neuronales suelen ser la opción razonable.
- En ambos casos, la adaptación con tu vocabulario del dominio sigue siendo la palanca más directa para mejorar.
No asumas que “neuronal” garantiza buenos resultados con tu audio. Un modelo moderno sin adaptación puede fallar con apellidos o nombres de calle que un sistema bien ajustado reconoce sin problema. La prueba con grabaciones reales decide, no la etiqueta de la tecnología.
Procesamiento y normalización del texto transcrito
Lo que devuelve el reconocedor rara vez está listo para usarse. La normalización convierte la transcripción en datos fiables, y en español tiene sus particularidades.
- Cifras y fechas: convierte las cantidades expresadas con palabras y las fechas en formatos estructurados. Define el formato antes de integrar con otros sistemas.
- Nombres propios y direcciones: valida contra una base conocida cuando sea posible, porque son los datos que más se corrompen.
- Mayúsculas y puntuación: como recuerda la RAE, la puntuación automática no recoge toda la prosodia, así que trátala como borrador.
- Negaciones: una frase como “no puedo pagar” cambia por completo si se pierde el “no”. Marca estas palabras para revisión.
- Muletillas y repeticiones: decide si las conservas, según el uso. Para auditoría conviene mantenerlas; para un resumen, se eliminan.
Aplica reglas simples y documentadas, y revisa una muestra cada semana. Si detectas el mismo error repetido, normalmente se corrige añadiendo el término a tu lista de adaptación y no con parches posteriores sobre el texto.
Acentos, dialectos y jerga en español
El español no suena igual en Madrid, Ciudad de México, Buenos Aires o Miami, y los códigos es-ES, es-419, es-MX y es-US existen por esa razón. Elegir el código que coincide con tus hablantes es la decisión más rentable que puedes tomar, según lo que documenta Google Cloud.
Qué hacer en la práctica:
- Si tus clientes están repartidos por varios países, prueba el mismo audio con más de una variante y quédate con la que mejor reconozca tus casos reales.
- Añade a la lista de adaptación la jerga y los localismos propios de tu sector o de tu zona, como nombres de barrios, modismos de pago o abreviaturas internas.
- No supongas que una variante cubre otra. Un modelo pensado para un acento puede degradarse con otro.
- Revisa los resultados con hablantes nativos de cada región antes de dar por buena una configuración.
Evita las promesas de “entiende todos los acentos”. Lo honesto es medir: toma una muestra por región, calcula los errores en nombres y cifras, y ajusta. Con ese ciclo, la precisión mejora de forma verificable y no por suposición.
Integración con CRM y plataformas de atención al cliente
Transcribir no sirve de mucho si el texto se queda aislado. El valor aparece cuando la conversación llega al CRM y dispara acciones: crear un ticket, registrar una promesa de pago o agendar una cita.
Un flujo habitual funciona así:
- La llamada entra por telefonía y el audio se envía al reconocedor en streaming.
- El agente de voz interpreta la intención y consulta o actualiza el CRM.
- Al terminar, la transcripción con etiquetas de hablante se guarda en la ficha del cliente.
- Los datos estructurados, como importes, fechas y motivos, alimentan informes y seguimiento.
En Anunzi integramos nuestros agentes de voz con CRM, agendas y telefonía. Si eres desarrollador, nuestra documentación de la API de llamadas explica cómo enviar y recibir datos de las llamadas. Y si quieres medir cuántas llamadas generan tus canales, una guía sobre número de tracking en la ficha de Google te ayuda a atribuirlas sin romper tu perfil de empresa.
Define desde el inicio qué campos necesitas guardar y en qué formato. Integrar con prisa y corregir después multiplica el trabajo.
Privacidad y seguridad en el procesamiento de voz
La voz es un dato personal y, en muchos casos, la llamada contiene información sensible: datos de contacto, importes, información de salud o de deuda. Trátala con el mismo rigor que cualquier otro dato de cliente.
Medidas que conviene aplicar:
- Informa al interlocutor de que la llamada se graba o se procesa, según la normativa de tu país. Consulta la legislación local aplicable, porque varía entre España y los países de Latinoamérica.
- Minimiza lo que guardas: conserva solo el audio y la transcripción que necesites y define un plazo de retención.
- Controla el acceso con roles, de modo que solo el personal autorizado escuche grabaciones o lea transcripciones.
- Cifra el audio y los textos, tanto en tránsito como almacenados.
- Revisa al proveedor: pregunta dónde se procesa el audio, cuánto tiempo se conserva y si se usa para entrenar modelos.
- Enmascara datos sensibles como números de tarjeta o documentos antes de guardarlos.
Documenta estas decisiones y repásalas cuando cambies de proveedor o añadas un canal nuevo. Una configuración segura hoy no lo es para siempre si el flujo cambia.
Por qué conviene un enfoque local en español
Mi opinión es directa: un agente de voz no se gana la confianza del cliente por la tecnología, sino por cómo suena y cómo resuelve en su contexto. Un tono, unos giros y unos procesos adaptados a tu país evitan frustraciones que ningún modelo corrige por sí solo. Por eso pesan tanto el soporte en tu idioma y las pruebas con audio real. Antes de decidir, escucha tus propias grabaciones y prueba.
— Matias
Agentes de voz en español para tu proyecto con Anunzi
Si quieres pasar de la teoría a un agente funcionando, nuestros agentes de voz responden en aproximadamente 1 segundo, resuelven más del 95 % de los casos sin derivar y quedan listos en 1 a 7 días. Atienden 24/7, de 1 a 20 llamadas simultáneas según el plan, desde 87 USD al mes con telefonía, como puedes ver en nuestros precios. En Villa María gestionamos 13.325 llamadas entre enero y julio de 2026 y el 85 % se resolvió sin transferir. Pide una demo y pruébala con tu propio audio.
Preguntas frecuentes
¿Cómo activar el reconocimiento de voz?
Comprueba primero que el micrófono funciona y que la aplicación tiene permiso para usarlo. Después activa la función de dictado o de voz en los ajustes del sistema o de la app. En Windows, la aplicación debe declarar la capacidad de micrófono, según Microsoft Learn.
¿Cómo activar el reconocimiento de voz en Android?
Abre los ajustes del teléfono, busca la opción de teclado o de entrada de voz y actívala, concediendo el permiso de micrófono cuando lo pida. Elige también el idioma español y, si puedes, la variante de tu región.
¿Qué IA se utiliza para el reconocimiento de voz?
Los sistemas actuales suelen apoyarse en modelos neuronales entrenados con grandes cantidades de audio y texto. Cada proveedor usa su propia arquitectura y documenta qué idiomas y funciones admite. Lo importante para ti es comprobar que soporta tu variante de español.
¿Cuál es el mejor clonador de voz?
Clonar una voz es una tarea de síntesis (TTS), distinta del reconocimiento de voz que tratamos aquí. No hay una respuesta única, y conviene verificar siempre el permiso de la persona cuya voz se reproduce. Si buscas voces para agentes, consulta nuestra guía de TTS en español para call center.
Fuentes
Recomendaciones
- Voces en español con IA para agentes conversacionales
- Confirmación de turnos por voz: guía práctica para clínicas
- TTS en español para call center: guía práctica 2026
- Promesas de pago automatizadas por voz: guía práctica
Escrito por
Fundador y CEO de Anunzi
Fundó Anunzi y lidera el producto y la tecnología de la plataforma de agentes de voz con IA en español. Trabaja con empresas y gobiernos de España y Latinoamérica para que ninguna llamada quede sin atender.
LinkedIn →